CoRL 2026 青年最高荣誉唯一华人得主清华赵行:「世界不会等模型」
时间是决定人形机器人量产的关键一环。 作者丨邓哲敏 编辑丨齐铖湧 此时此刻,美国奥斯汀,机器人学习领域的顶会 CoRL 2026 正在如火如荼地举行。清华大学交叉信息研究院助理教授、星海图 CTO 赵行,在这届大会主会场上登台,发表了 Early Career Keynote 演讲(青年成就奖)。 与动辄万人规模的 A
时间是决定人形机器人量产的关键一环。
作者丨邓哲敏
编辑丨齐铖湧
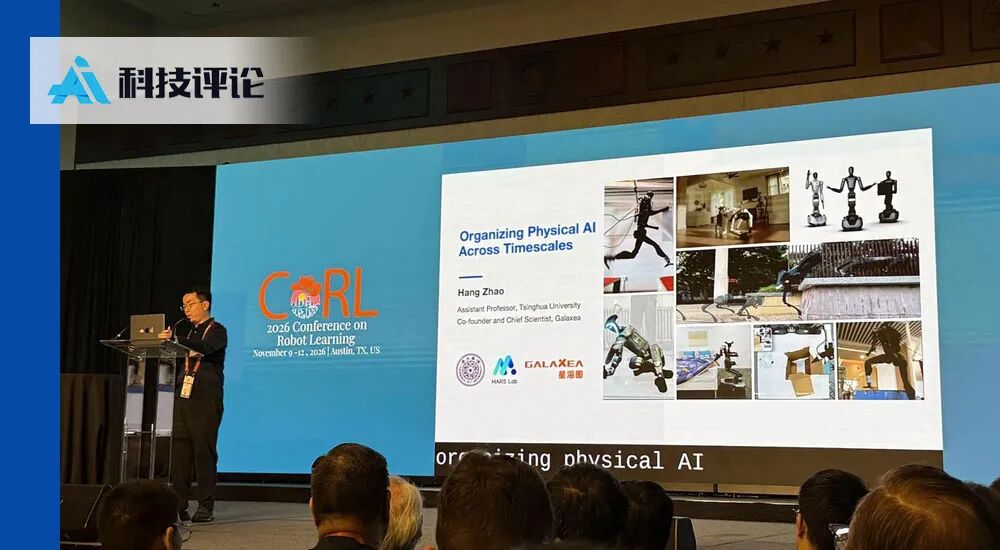
此时此刻,美国奥斯汀,机器人学习领域的顶会 CoRL 2026 正在如火如荼地举行。清华大学交叉信息研究院助理教授、星海图 CTO 赵行,在这届大会主会场上登台,发表了 Early Career Keynote 演讲(青年成就奖)。
与动辄万人规模的 AI 大会不同,CoRL 是泛具身领域极其严肃专注的顶会,台下坐着的几乎全是这个星球上最懂机器人学习的学者。
Early Career Keynote 须同行提名、不得自荐,专门授予博士毕业十年内、已在机器人学习领域留下实质成果的年轻研究者,被视为该领域对新星研究者最高规格的认可之一,也是每年 CoRL 为主会场定调的重头戏。
今年全球仅有三位学者获此殊荣,而赵行是其中唯一的中国面孔。
站在台上的赵行,一方面串联过往的学术历程,讲述了自己从学术到产业的思考,另一方面,面对近期 GPT-6 Astra 接入机器人引发的行业焦虑,用一套极其严密的“时钟理论”,戳破了当下具身行业里不计时间成本制造出的基准测试幻觉,给了具身行业一个耳目一新的思考角度。
AI 科技评论(雷峰网)在现场全程记录了这场演讲,并结合赵行的学术研究路径,给大家带来这位中国顶尖年轻研究者的观点分享:
01
时间是决定人形机器人
**量产的关键一环
**
今天我想谈“机器人的时间”:机器人智能应当如何在不同的时间尺度上组织起来。
我从 Waymo 的轮式自动驾驶起步,七年前发表了第一篇 CoRL 论文;然后转向有腿的机器人,花几年教四足和人形机器人奔跑、跳跃、征服复杂地形;现在做带手臂的机器人。归根结底,我们希望机器人替人类做真正的体力工作。
昨天我抵达奥斯汀,街上到处是 Waymo 和 Cybercab。对从自动驾驶起步的人来说,这感觉很好——驾驶已进入量产。人形机器人也能做到吗?今天我分享答案的一部分,它与时间有关。
最近 GPT-6 Astra 发布,几天内人们就把它接入自己的机器人,发现直接能用。NVIDIA 研究者在 RoboLab-120 仿真上做了细致研究:Astra 任务成功率 66%,π0.5 只有 28%。在另一个基准 RoboDojo 上结果类似:Astra 22 分,π0.5 仅 7 分。这很惊人,我相信领域里很多人还没准备好。
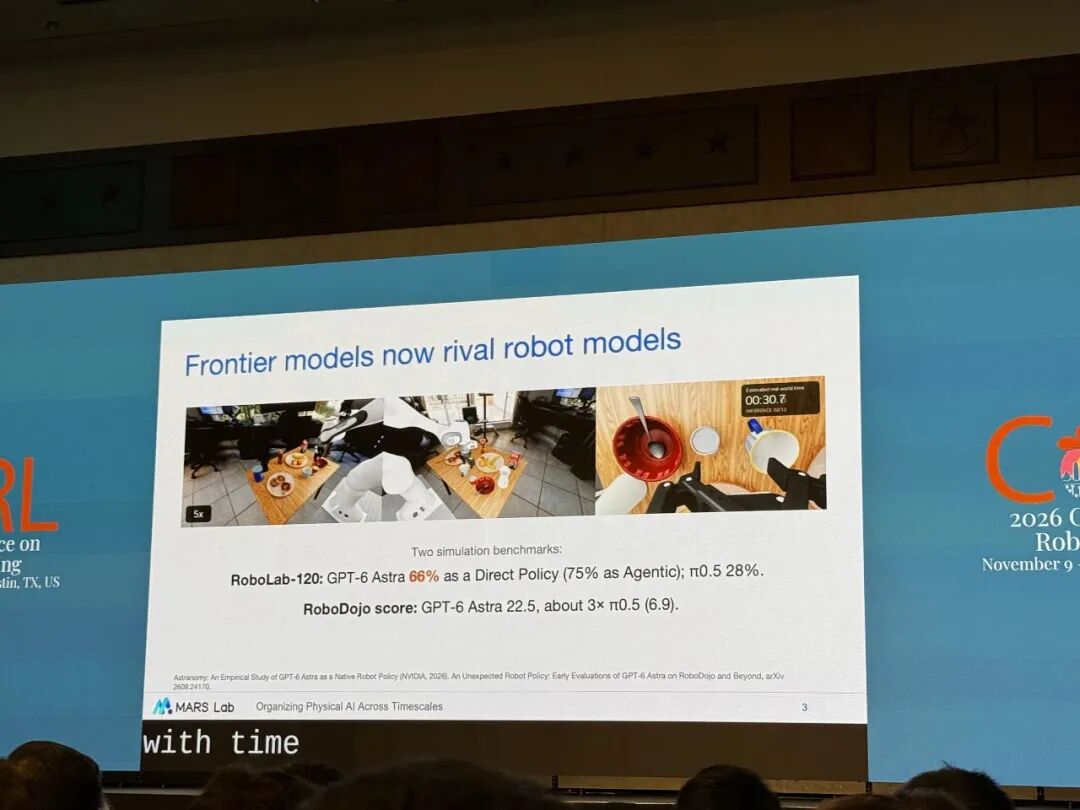
但有个问题:这些基准不测时间。Astra 用的是直接策略,直接控制机器人。仔细看,每次调用基础模型要 18 秒,机器人 97% 的时间在等模型思考。但现实中,机器人等不了模型思考这么久。
前沿模型非常好,我们该怎么用?为了弄清楚这事,我在家庭厨房仿真器 RoboCasa 里做了受控实验:5 个机器人从未见过的测试厨房、5 项任务,每项限 50 秒。
我试了五种控制方式:一是编程策略,让前沿模型理解任务后写代码,部署时程序直接跑,不再调模型;二是编程加询问,代码运行时失败就向模型求助,平均每回合只调一次;三是编排策略,前沿模型调度不同技能,每回合约调 4 次;四是直接策略;五是智能体策略,每步可控机器人、可调用工具计算,更费 token。
如果不限制思考时间,这些方法表现都不错:除编程策略 45% 外,其余成功率都超 60%。但加上真实时钟就完全不同了:直接策略和智能体策略成功率分别跌到 15% 和 20%。
这告诉我们,慢模型没问题,只要它与 System 1 结合,比如编排策略用小神经网络技能处理高频控制。
正如赵行所说,自动驾驶已然量产,而人形机器人似乎还在另一个时区。那么,自动驾驶有什么经验可以迁移?也许需要铺垫一段赵行的背景,大家会更明白他所希望表达的。
早在 2015 年的 MIT Media Lab,赵行就参与开发了世界上首个自动驾驶课程 Duckietown 的实践项目,也是在那时,他主动申请去做机器人课的助教,跟着韩国学者 Sangbae Kim 捣鼓 MIT Cheetah 猎豹机器狗。在与 AI 科技评论此前的对话中,赵行提到一个细节,那时候机器狗极度脆弱,上个飞机要走货运,去一次展会光维修和运输就要烧掉 3 万美元。
这段经历让他比任何人都清楚:实验室里的 demo 和产业级的产品之间,隔着一道名为“鲁棒性”的深渊。因此,当他在演讲中指出大模型直控的成功率会在真实时钟下暴跌时,这绝非纸上谈兵,而是他的真实经验所谈。
02
**时钟定义层级
**
层与层的界限该画在哪里?老派答案按功能划分:感知、规划、控制。我主张另一种答案:**时钟定义层级,在时钟变化处画线。**这里讲 System 0/1/2,指的不是思维层面的快慢,而是时间尺度上的层级。
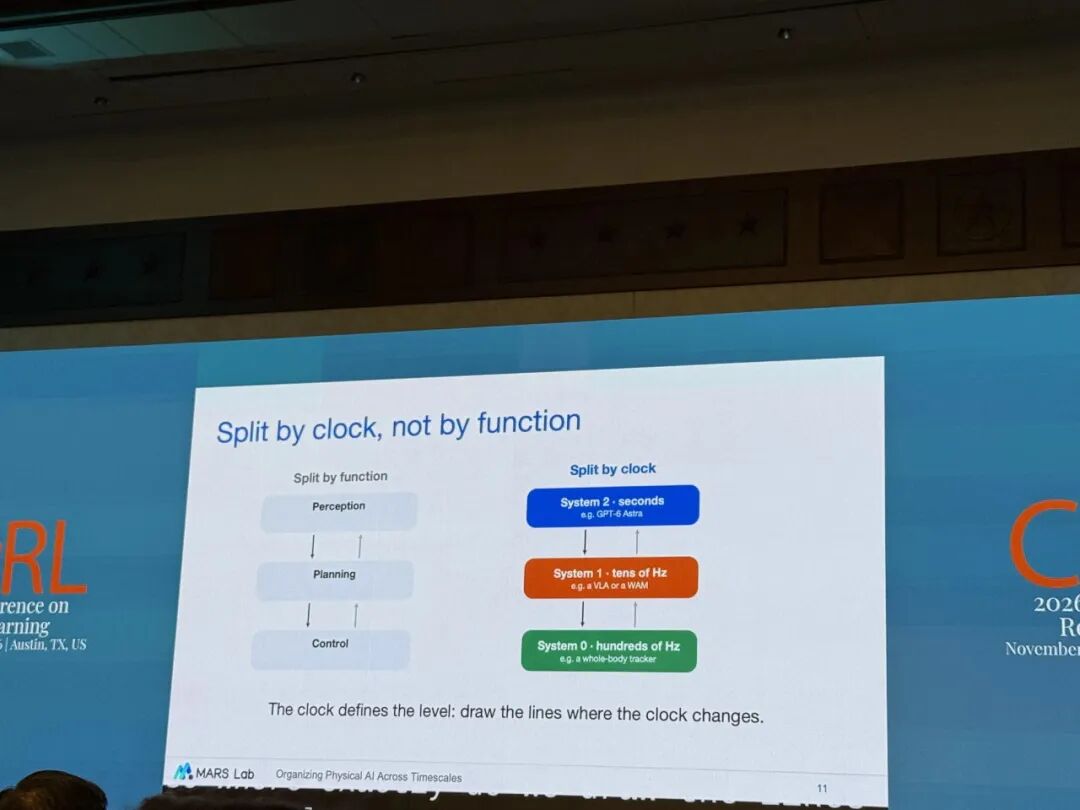
判断一件事属于哪层,要分两步。先问这一层必须对什么做出反应,这决定时钟要多快;再由时钟决定层级。System 2 要利用过往经验理解当下,时钟以秒到分钟计;System 1 要以交互发生的频率响应机器人手与物的相对运动,几十赫兹;System 0 要跟踪接触与力,所以必须几百赫兹。
我在自动驾驶时遇到过同样棘手的问题。我们把 VLM 装进车里,发现它理解场景能力惊人,能看懂学校区域、减速等孩子过马路,但它无法即时响应驾驶任务。于是我们把慢 VLM 和快驾驶栈装进同一辆车,这套系统如今已大规模跑在量产车上。我从自动驾驶得到的经验是:让快的层开车,让慢的层思考,各走各的轨道。
2023 年我们的四足机器人从视觉中学跑酷,随后做到全尺寸人形,今年实现全身跑酷——手脚并用攀爬、与环境交互。自己读深度、毫秒级反应,整个系统就是一个 System 0。跑酷给我上了第二课:反射必须住在快的层,且这一层要独立完成从感知到动作的全部事项。
但现实更复杂,一个任务往往需要多层配合。试想几个场景:工业装配线,固定重复,只需 System 0;物流分拣,任务固定但每个包裹不同,需要很强的 System 1;餐厅服务,要交谈、下单、端盘子,三样都要一点;做家务,任务定义复杂、跨度大,需要很强的 System 2,但速度可慢,System 1 和 0 稍弱即可。
这套分层系统还有两个关键问题要解决:每层如何快到跟得上自己的时钟?层与层之间传递什么?
*这段分享中,*赵行并没有否认大模型应用于具身智能的可能性,相反,他认可前沿模型的能力,试图通过解决时间延迟来更好地组织各类模型。
“让快的层开车,让慢的层思考”,这套具身思路并非仅仅停留在学术领域。
2019 年,赵行从 MIT 博士毕业,加入 Waymo,亲历了自动驾驶从实验室走向规模化量产的过程。2020 年下半年他回国加入清华叉院,从四足跑酷一路做到带臂操作,把视觉感知与全身控制推向极限运动的难度级别。
据**AI 科技评论了解,赵行曾和与小一届的师弟王轶伦多次聊起自动驾驶的痛点。两人基于共同的技术嗅觉,自下而上地促成了后来与理想汽车的合作。当时全球打通数据闭环的车企屈指可数,而理想的工程基建为 DriveVLM 提供了土壤。
对此,赵行曾剖析过其中的区别:L2+ 级别或许能靠小模型的端到端肌肉记忆应付,但 L4 级别必须依赖大模型解决长尾问题。于是,DriveVLM-Dual 快慢双系统应运而生,大模型负责慢思考,传统规控负责快响应,如今这套方案已经实打实地落地超过 40 万辆量产车。
这也是为什么当他在 CoRL 讲台上抛出时钟定义层级时,台下的工业界同行会非常认同。
03
**让每一层快速运转的三项工作
**
先谈第一个问题:让每一层都足够快。
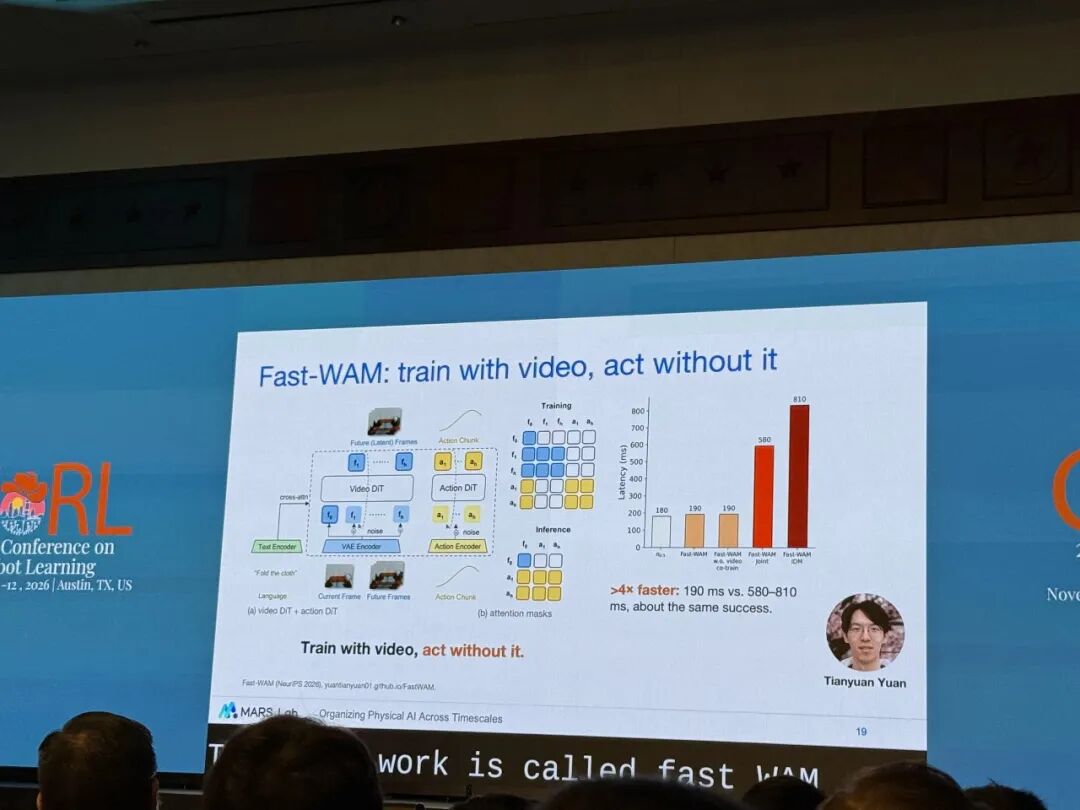
今天的 System 1 普遍太慢,跟不上几十赫兹,原因有三个,且都源于模型的出身。其一,若你的动作模型基于视频生成模型,你会知道视频生成其实很慢,生成 5 秒高清视频要 2 到 3 分钟,无法上机。其二,若你的 VLA 基于 VLM,则文本推理动辄 5 秒,对控制不可承受。其三,几乎所有工作——VLA、扩散策略、动作模型——都先解码整条动作块再执行,白白等待。我们有三项工作分别应对。
**第一,Fast-WAM。**世界动作模型往往在行动前先生成未来视频。Fast-WAM 让视频模型与动作模型共享权重,训练时只做一点注意力改动——训练时想象,测试时可以跳过,提速 4 倍以上。今年我们有了更强版本,参数量从 5B 扩到 16B,采用混合 Transformer 架构,优化后在 RTX 5090D 上每个动作只要 60 毫秒。
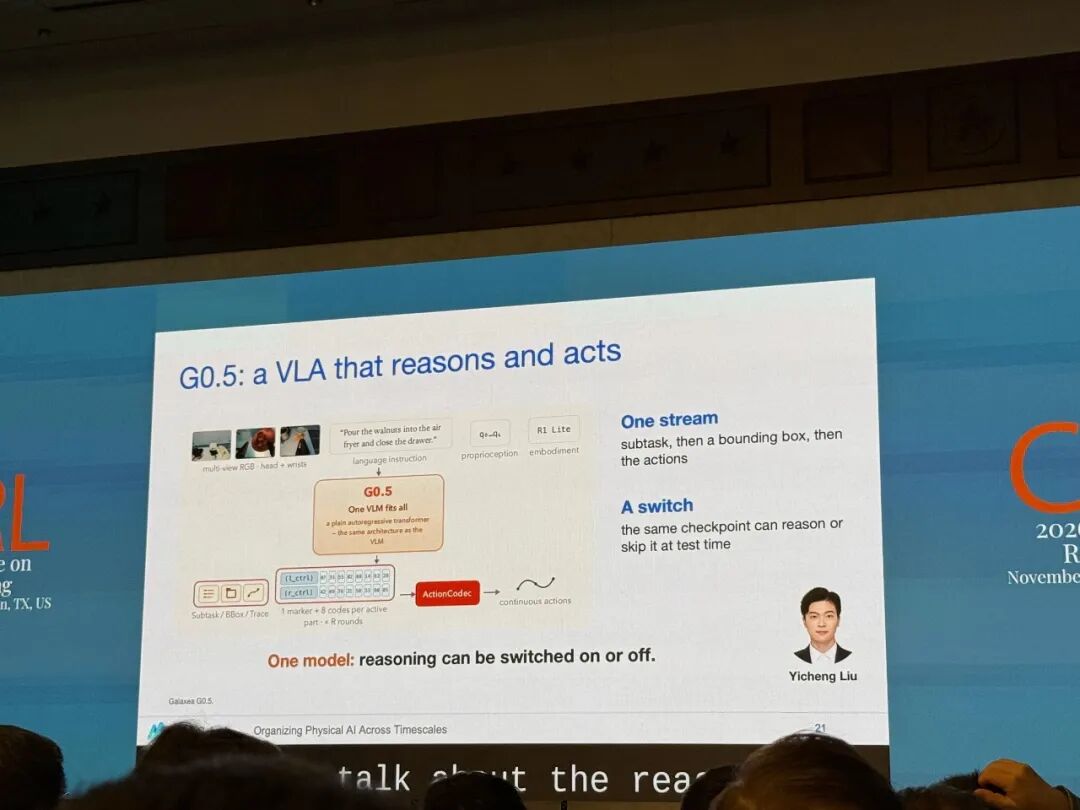
**第二,G0.5。**这是我们星海图自研的 VLA 模型,以视觉和文本为输入,把任务、边界框、动作轨迹写进同一条离散 token 流。在同一组模型权重上,我们可以简单地开启或关闭推理。结果令人惊讶,90% 的任务上,有无推理成功率完全相同;跳过推理,速度快一倍;推理只在长程任务上有用。
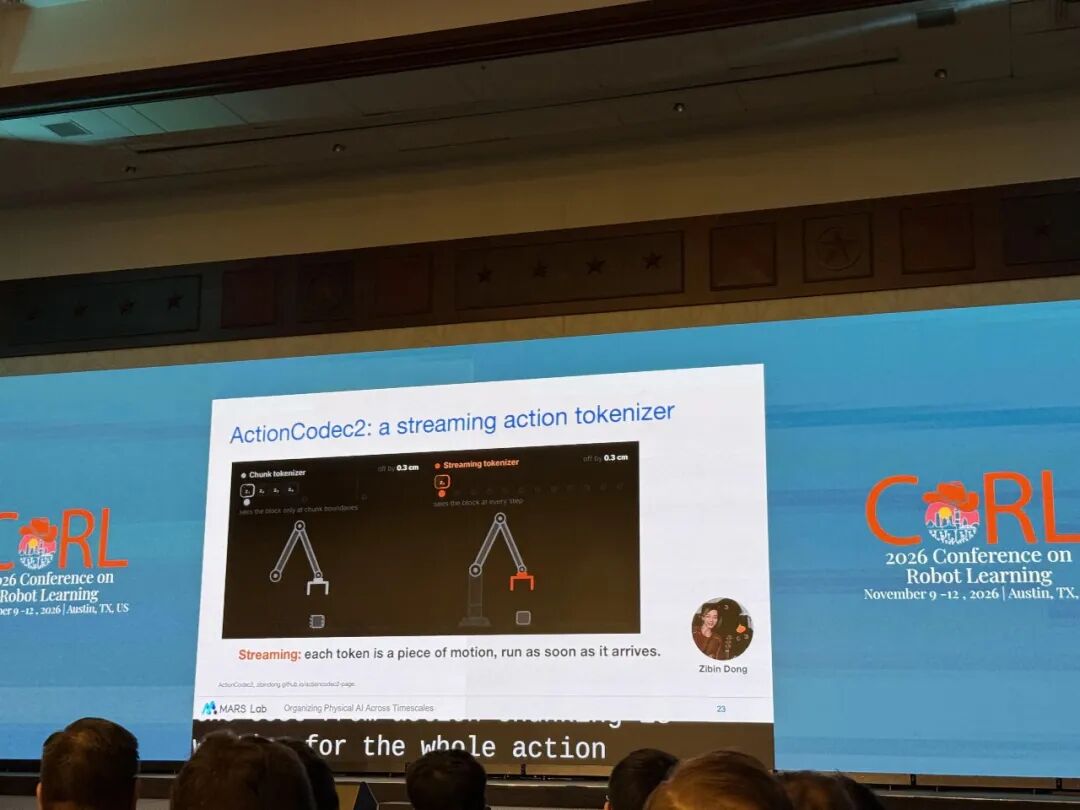
第三,ActionCodec2。动作分块带来的成本,是必须等整条动作轨迹生成完毕才能开始执行。这段动画来自我们的工作,画面中机械臂在追踪一个不断移动的方块。左边是分块 tokenizer,策略必须先解码完整的一块动作,机器人才能移动,因此它只能在块与块的边界处看到方块的位置。想更及时,就得解码全新的一块动作。右边是流式动作 tokenizer,每个 token 都是一小段运动,机器人一收到就立刻执行,所以它在每一步都能感知到方块的位置。注意看结尾,分块那侧的手臂跟丢了,流式那侧的手臂抓住了。这就是我们所说的流式动作组织方式,用它,我们就可以构建一个流式 VLA。
这一段,赵行介绍了很多团队成员的工作,他作为一名年轻老师,能在学术界提出理论,又能在产业界和团队一起交出 Fast-WAM、G0.5 这样硬核工作,在我们看来,离不开他此前在 Waymo 时期受到的极限锤炼。2019 年他加入了刚成立研究院的 Waymo。那里人才济济,bar 极高,坐在他左边的可能是 PointNet 的作者祁瑞中,管理级别最高的周寅做过 VOXnet。
在那个扁平且鼓励跨界合作的体系里,他遇到了比自己早两个月入职的高继扬。
高继扬既能交付产品又能做研究,“一个人干俩人的活”,两人跨三个组合做出了引领行业的 VectorNet。2023 年上半年,当机器人的创业时机如同 2016 年的自动驾驶一样成熟时,两人再次一拍即合成立了星海图。
赵行曾公开回忆过那个瞬间:“你找我创业,我肯定和你一起,方向我们可以再找,但和你创业我现在就可以答应。”正是这种极度互信的搭档关系,让那些关于“流式动作”和“提速 4 倍”的构想,迅速变成了具身智能公司的核心壁垒。
接下来,最关键的是,各个层间该传递什么信息。
04
层间传什么:
**向下较为丰富,向上几乎空白
**
接下来谈谈第二部分,层间传递什么。
三条时钟两条边界,双向通行。向下:System 2 传给 1 语言、目标、程序、动作;System 1 传给 0 运动。向上:System 0 反馈接触、力、跟踪状态;System 1 反馈进度、置信度与状态。但今天多数工作只做向下通路,向上通路严重缺失。
向下我们已有一些工作。WB-WAM 是为人形机器人生成全身动作的世界动作模型。作为 System 1,它输出全身和手的姿态,以及未来动作轨迹。更进一步有 OMG,一个动作多种输入。System 2 发送文字、音乐、参考姿态给 System 1,System 1 再转成可执行轨迹,由 System 0 跟踪。尽管 System 2 和 1 之间有丰富的交互,但 System 1 到 0 之间,向下传的仍只有运动。
**只有运动是不够的。**机器人只知道跟着轨迹,不知道目的,而且交互的本质是力,比如擦桌子,几乎只有力、没有运动。所以,现在人们已经开始超越运动,从关节目标,到身体运动,到接触,再到力。
超越运动的第一步是保持接触,无论是最早的那批重定向工作,还是我们发表在本次 CoRL 上的工作,都在尽力保住机器人与物体之间的接触点和几何关系。但说实话,这类方法只保住了接触几何,它们对力还一无所知。
最近我注意到 UC Berkeley 的一项工作 Ctrl-F。它给跟踪器参考动作和每只手的力指令;顶层再配一个小规划器,根据它实时看到的情况来调力。下面是一个机器人推 20 公斤重箱子的例子,左边,SONIC 只跟踪运动,箱子纹丝不动;右边,他们的模型能推动箱子。注意是谁在决定力,是那个贴近物体的小规划器,也就是 System 1,而不是远在顶层的慢模型。

我们再来看看失败案例。底层系统大多时候自己行动,却不知道自己已经失败;高层系统不够快,没注意到任务已失败。这些失败都落在层与层之间,而今天,跨边界的反馈是缺失的,我认为我们迫切需要这套反馈机制。

05
**分层或单模型,都需考虑时钟
**
最后,我认为未来有两条路。
第一条是分层路线:每层有自己的时钟,上层不去精确指定接触和力,它向下发意图,下层向上发反馈。难点在于,下层必须能自己感知到失败、自己纠正,并主动上报。
第二条是单模型路线:统一架构共享权重,每个时钟配各自的专家,推理时以不同时钟运行。好处是架构统一、共享上下文、KV cache 可复用。难点是如何联合训练:System 1、2 靠行为克隆,System 0 靠仿真强化学习,两套训练机制如何放进同一个环境里一起训?
无论哪条路,时钟都必须是模型设计的一部分。
总结一下:在机器人领域,世界不会等模型。系统要对什么做出反应,决定了它的时钟;要选配得上时钟的模型,而不是反过来。层间要向下发意图、向上报失败。不要只造一个快模型或一个小模型,要造整个系统。最后我恳请社区,以后做机器人仿真基准,请同时报告截止时限前的成功率和所需推理时间。

演讲结束时,奥斯汀会场的掌声很热烈。
对于台下的同行而言,这不仅是一场关于 System 0/1/2 的技术拆解,更是一份来自产业一线的深度思考。
在赵行看来,技术的演进从来不是孤立的算法游戏。他曾跟 AI 科技评论聊起过一个宏大的命题:到底什么样的技术值得投入一生?当年毕业时,自动驾驶和**AR/VR 是最火的两个方向,但他果断放弃了后者。类似的观点他的好友楼天城也曾提到,AR/VR 难以发展不仅是因为技术不成熟,更因为它向社会输出的正向价值太小。而自动驾驶和具身智能,因为与人的生命息息相关、能真正替代人类进行物理劳动,即使过去十年一直在烧钱,也总有行业力量前赴后继地接力。
这也是为什么,2020 年回到清华后,他拒绝将自己的实验室命名为“计算机视觉”或“深度学习”,而是取名 MARS,做一个纯粹的 AI 实验室。因为他深知,神经网络正在抹平语音、图像与控制的传统界限。
从 2015 年在 MIT 修一台动不动就坏的机器狗,到如今站在 CoRL 的讲台上定义人形机器人的时钟法则;从 Waymo 的前几名研究员,到星海图的 CTO。赵行一直走在物理世界 AI 的最前线,并且始终确信:不要只造一个快模型,要造整个系统;不要只看基准测试的分数,要看它对现实世界的价值。
让我们再次恭喜赵行老师。
国际机器人顶会 CoRL 2026 即将召开,欢迎参会的研究者、学生,以及关注 AI 前沿进展的读者加入我们的交流群。
在这里,你可以认识同行、交流研究,分享招生信息、科研合作、约饭、投稿、组队参会等,寻找潜在的合作伙伴。
大会期间,我们也会持续带来现场报道速递、嘉宾演讲解读、前沿方向梳理和论坛精华。
会场见,也在群里见。
? 进群传送门: 扫码进群或添加微信szhsn610,备注:CoRL+单位/学校+姓名+方向。


